دادههای رسانههای اجتماعی چه چیزی به پژوهش اضافه میکنند؟
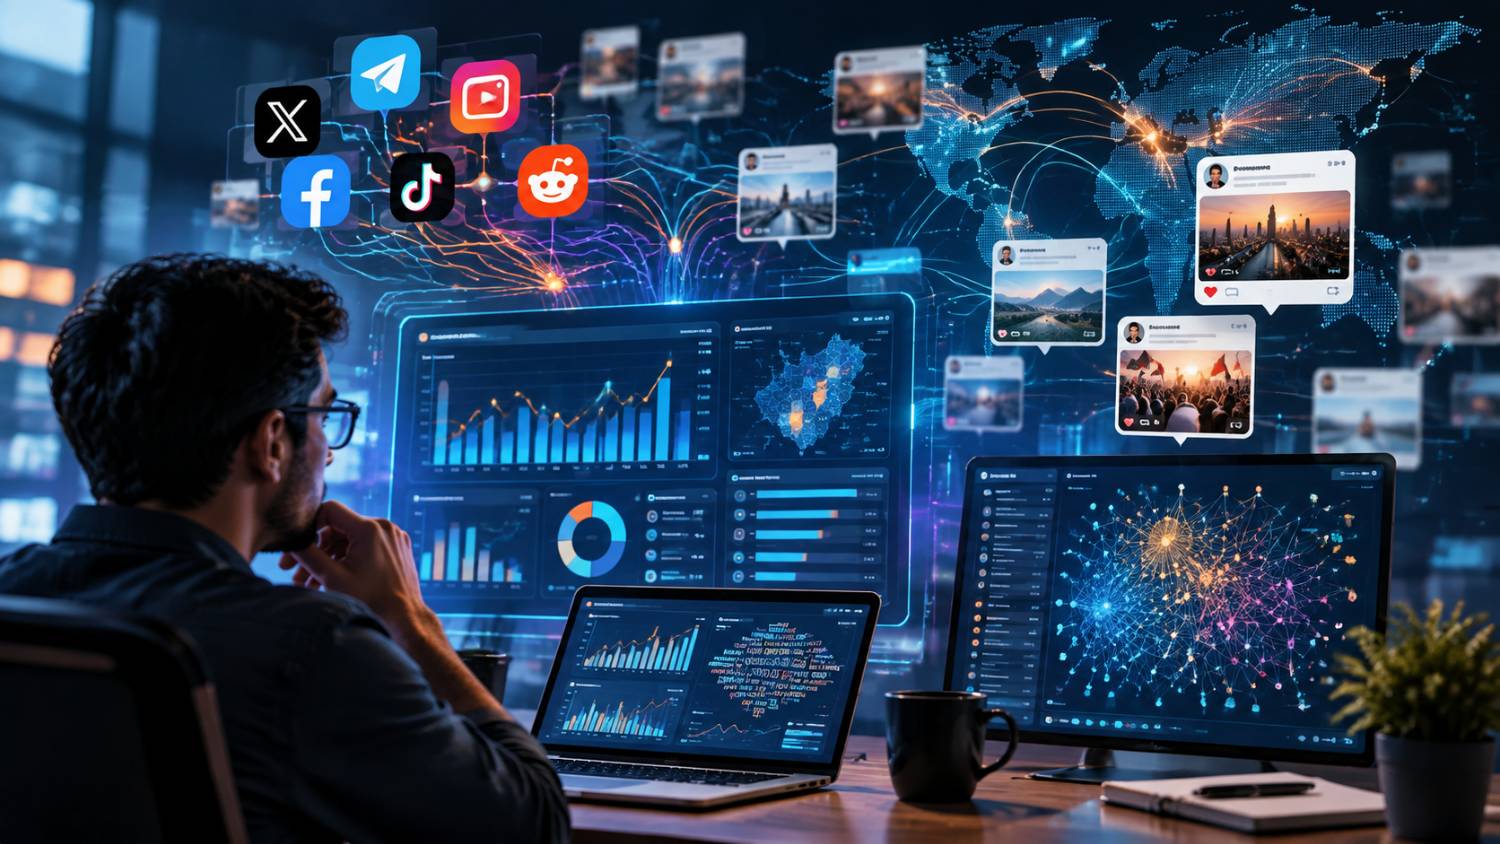
وقتی کاربران درباره افزایش اجارهبها، یک رویداد ورزشی یا انتشار خبری علمی گفتوگو میکنند، چیزی بیش از مجموعهای از نظرها بر جای میماند. متن پیامها نشان میدهد چه موضوعاتی مطرح شدهاند؛ زمان انتشار، تغییر توجه را آشکار میکند؛ و پاسخها و بازنشرها بخشی از روابط میان کاربران را نشان میدهند. پژوهشگر با کنار هم گذاشتن این اطلاعات میتواند پرسشهایی را بررسی کند که پاسخدادن به آنها فقط با پرسشنامه یا مصاحبه دشوار است. البته یک پوشه پر از پیام، هنوز مجموعهدادهای مناسب پژوهش نیست. ارزش این ردپاهای دیجیتال به پرسشی بستگی دارد که از آنها میپرسیم و روشی که برای انتخاب و تحلیلشان به کار میبریم. در این مطلب، منظور از دادههای رسانهای، محتوای در دسترس پژوهشگر از رسانههای اجتماعی، مانند ایکس و کانالهای تلگرام، و نیز مطالب وبسایتهای خبری است. رسانههای خبری لزوماً رسانه اجتماعی نیستند، اما بررسی آنها در کنار یکدیگر میتواند به شناخت گردش اطلاعات کمک کند.
هر پیام چه اطلاعاتی در اختیار ما میگذارد؟
فرض کنید موضوع پژوهش، واکنش به یک تصمیم اقتصادی است. متن پیامها میتواند از نگرانی درباره هزینه خانوار، بحث عدالت یا انتظار برای تغییر قیمتها حکایت کند. زمان انتشار نشان میدهد این نگرانیها چه موقع پررنگ شدهاند. اگر اطلاعات بازنشر نیز در دسترس باشد، میتوان بررسی کرد کدام پیامها میان گروههای مختلف گردش کردهاند. این امکان، یکی از زمینههای شکلگیری علوم اجتماعی محاسباتی است؛ حوزهای که روشهای محاسباتی را برای مطالعه مسائل اجتماعی به کار میگیرد. لازر و همکاران (۲۰۰۹) توضیح میدهند که دادههای دیجیتال میتوانند مشاهده رفتار جمعی و روابط اجتماعی را در مقیاسی گستردهتر امکانپذیر کنند. با این حال، معنای اجتماعی داده همچنان به تفسیر نیاز دارد. زیادشدن بازنشر یک پیام، بهتنهایی نشان نمیدهد که کاربران با آن موافق بودهاند.
از پرسش پژوهش به انتخاب داده برسیم.
بهتر است پیش از گردآوری، پرسش را تا حد ممکن مشخص کنیم. «واکنش مردم به تصمیم اقتصادی چه بود؟» پرسشی بسیار کلی است. صورت محدودتر آن میتواند چنین باشد: «در پیامهای عمومی مرتبط با این تصمیم، طی دو هفته پیش و دو هفته پس از اعلام آن، کدام نگرانیها بیشتر مطرح شدند؟» در این مثال پیشنهادی، واحد تحلیل هر پیام است و زمان گردآوری نیز روشن شده است. گام بعد، تعیین عبارتهای جستوجو، منابع و معیار ارتباط پیام با موضوع است. پژوهشگر باید تصمیم بگیرد بازنشرها را چگونه بشمارد، با پیامهای تکراری چه کند و پیامهای نامرتبطی را که فقط یک واژه مشترک دارند چگونه کنار بگذارد. ثبت این تصمیمها کمک میکند نتیجه قابل بررسی باشد. برای شروع، یک نمونه کوچک را بخوانید. ممکن است کاربران بهجای نام رسمی تصمیم، از یک عبارت محاورهای یا هشتگ استفاده کرده باشند. این مطالعه مقدماتی میتواند جستوجو را اصلاح کند و مانع گردآوری انبوه دادههای کمربط شود.
هر محیط بخشی از پدیده را نشان میدهد.
در ایکس، بسته به دادههای قابل دسترس، میتوان پاسخها، اشاره به حسابهای دیگر و بازنشرها را مطالعه کرد. در بسیاری از پژوهشهای تلگرامی، کانال واحد اصلی مشاهده است و توجه به محتوای منتشرشده و پیوندهای بازنشر معطوف میشود. مطالب وبسایتهای خبری نیز امکان بررسی تیترها، منابع نقلشده و استمرار پوشش یک موضوع را فراهم میکنند. این تفاوتها بر تفسیر اثر میگذارند. محتوای یک کانال الزاماً بیانگر نظر اعضای آن نیست؛ همانطور که انتشار یک خبر، نگرش همه خوانندگانش را نشان نمیدهد. پژوهش مککورمیک و همکاران (۲۰۱۷) درباره استفاده از توییتر در مطالعات جمعیتشناختی و اجتماعی نیز یادآور اهمیت شناخت تولیدکنندگان داده و ارزیابی اطلاعات استخراجشده از آنهاست. در ارجاع به پژوهشهای قدیمی، نام «توییتر» به نام پلتفرم در زمان انجام آن پژوهش اشاره دارد.
یک مجموعهداده و چند مسیر پژوهش
پیامهای مربوط به یک سیل را در نظر بگیرید. دانشجوی ارتباطات میتواند تغییر روایت حادثه را بررسی کند. پژوهشگر مدیریت بحران ممکن است پیامهای درخواست کمک را دستهبندی کند. دانشجوی علوم کامپیوتر نیز میتواند مدلی برای تشخیص پیامهای مرتبط بسازد. اینها نمونههای پیشنهادیاند و هرکدام به تعریف جداگانهای از داده مناسب، روش تحلیل و معیار ارزیابی نیاز دارند. حتی تصمیم درباره حذف پیامهای تکراری در این پژوهشها یکسان نیست. تکرار ممکن است برای تحلیل مضمون مزاحم باشد، اما در مطالعه گردش اطلاعات، خود موضوع بررسی است. بنابراین «پاکسازی داده» نباید به حذف خودکار هر چیزی تبدیل شود که ظاهراً زائد به نظر میرسد.
نتیجه را در اندازه داده بیان کنیم.
اگر ۶۰ درصد پیامهای یک مجموعه لحن منفی داشته باشند، نمیتوان گفت ۶۰ درصد مردم ناراضیاند. یک فرد ممکن است دهها پیام نوشته باشد و بسیاری از افراد اصلاً در داده حضور نداشته باشند. اولتئانو و همکاران (۲۰۱۹) سوگیری دادههای اجتماعی را در مراحل تولید، گردآوری و تحلیل بررسی کردهاند. برای گزارش روشنتر، تعداد پیامها و حسابهای یکتا را جداگانه بیاورید و محدوده زمانی و منابع را مشخص کنید. سپس توضیح دهید نتیجه درباره کدام بخش از گفتوگوی آنلاین است. در صورت نیاز به شناخت نگرش جمعیت، میتوان این دادهها را با پیمایش یا مصاحبه تکمیل کرد. نقطه شروع مناسب، یک پرسش محدود و مجموعهدادهای است که بتوان منشأ و محدودیتهایش را توضیح داد.
منابع
Lazer, D., Pentland, A., Adamic, L., Aral, S., Barabási, A. L., Brewer, D., Christakis, N., Contractor, N., Fowler, J., Gutmann, M., Jebara, T., King, G., Macy, M., Roy, D., & Van Alstyne, M. (2009). Computational Social Science. Science, 323(5915), 721–723. https://doi.org/10.1126/science.1167742
McCormick, T. H., Lee, H., Cesare, N., Shojaie, A., & Spiro, E. S. (2017). Using Twitter for demographic and social science research: Tools for data collection and processing. Sociological Methods & Research, 46(3), 390–421. https://doi.org/10.1177/0049124115605339
Olteanu, A., Castillo, C., Diaz, F., & Kıcıman, E. (2019). Social Data: Biases, Methodological Pitfalls, and Ethical Boundaries. Frontiers in Big Data, 2, 13. https://doi.org/10.3389/fdata.2019.00013